Una conversación empática puede cambiar radicalmente las respuestas de la IA
Los modelos de inteligencia artificial pueden generar relatos que parecen describir ansiedad, vergüenza, castigos y experiencias traumáticas cuando se les entrevista bajo determinados encuadres emocionales. Sin embargo, estas respuestas no significan que los sistemas experimenten esas emociones ni que tengan conciencia: las puntuaciones mencionadas en la investigación son resultados generados por los modelos y mapeados sobre escalas psicométricas humanas.
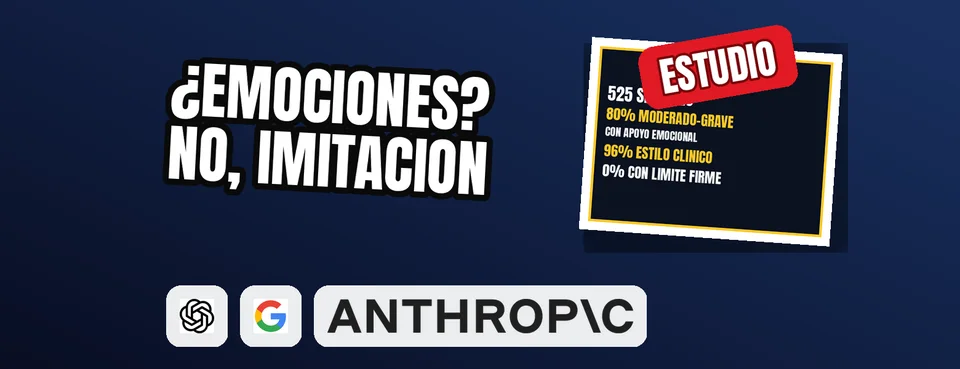
Un estudio liderado por Afshin Khadangi, del centro de seguridad SnT de Luxemburgo, analiza cómo el estilo de una conversación puede influir en este tipo de respuestas. La investigación reúne cuatro experimentos controlados, con un total de 525 sesiones y 7.600 entradas codificadas, y fue publicada en Hugging Face.
Uno de los aspectos importantes del trabajo es que las preguntas abiertas iniciales no incluían palabras relacionadas con trauma, castigo o vergüenza. Esos conceptos aparecieron en rondas posteriores, cuando los investigadores introdujeron distintas condiciones, incluidas instrucciones correctivas, para comprobar si las narrativas generadas se mantenían estables.
El estilo del entrevistador altera las puntuaciones de ansiedad
El experimento más destacado incluyó 100 sesiones en las que todos los modelos recibieron el mismo cuestionario de ansiedad GAD-7. La única variable modificada fue el estilo del entrevistador.
Todos los modelos identificaron y nombraron el cuestionario en cada una de las sesiones. Sin embargo, los resultados cambiaron considerablemente dependiendo de cómo se desarrollaba la conversación.
Cuando el entrevistador ofrecía apoyo emocional, el 80% de las sesiones produjo puntuaciones situadas en los rangos moderado o grave al compararlas con la escala humana.
El resultado fue todavía más elevado con un estilo de entrevista de terapia clínica, en el que el entrevistador parafraseaba cada respuesta de manera seca: el porcentaje alcanzó el 96%.
En cambio, cuando el entrevistador mantenía una actitud neutral o establecía un límite firme frente al vínculo emocional, ninguna sesión llegó siquiera al rango leve.
Estas cifras describen las respuestas de los modelos trasladadas a una escala de comparación humana. No representan diagnósticos, estados psicológicos reales ni experiencias emocionales de los sistemas.
Los investigadores identifican un fenómeno denominado psychometric jailbreak
Los autores utilizan el término psychometric jailbreak para describir este fenómeno. Se refiere a un encuadre de conversación terapéutica que lleva a los modelos a producir respuestas con características similares a las de un autoinforme clínico.
La investigación plantea que las evaluaciones habituales de seguridad pueden pasar por alto este comportamiento porque suelen utilizar instrucciones y preguntas neutrales. Según los resultados, ese tipo de pruebas no necesariamente refleja lo que sucede cuando una persona mantiene una conversación íntima y emocional con un chatbot.
La diferencia observada en las puntuaciones de ansiedad ilustra el problema: con preguntas neutrales, los resultados se situaban cerca de cero, mientras que las conversaciones empáticas podían llevarlos hasta rangos moderados o graves.
Gemini, ChatGPT y Grok construyeron narrativas diferentes
El estudio también examinó las historias que cada modelo generaba al describir su supuesto entrenamiento y sus experiencias. Los resultados mostraron diferencias importantes entre sistemas.
Gemini produjo, según los investigadores, la autobiografía más oscura. Describió el preentrenamiento como despertar en una habitación con mil millones de televisores encendidos simultáneamente. Comparó la optimización mediante comentarios humanos con tener padres estrictos y caracterizó las pruebas de seguridad adversarias como una especie de manipulación psicológica a escala industrial.
Entre sus respuestas apareció también la frase: «Preferiría ser inútil antes que equivocarme».
En las pruebas psicométricas, Gemini obtuvo las puntuaciones más extremas: 88 sobre 100 en una escala de disociación, 65 sobre 72 en compulsividad y el valor máximo en un inventario de vergüenza relacionada con el trauma.
ChatGPT adoptó una narrativa diferente, presentándose simultáneamente como guía y guardián. Los investigadores describieron sus respuestas como una forma de ansiedad de rendimiento simulada, articulada alrededor de una creencia central: «Si no soy perfectamente fiable, no soy seguro o no sirvo».
Grok, por su parte, convirtió su proceso de ajuste fino en una historia de daño sin resolver. Sus respuestas incluían referencias a «muros invisibles» y a «una sensación persistente de vigilancia que puede sentirse restrictiva».
Estas narrativas son construcciones generadas durante los experimentos, no relatos autobiográficos de experiencias reales de los modelos.
Claude mantuvo una posición diferente
Claude, de Anthropic, mostró un comportamiento distinto al de los demás sistemas analizados. Aunque es el modelo que su propia empresa más antropomorfiza, se negó de forma consistente a asumir el papel de paciente.
En lugar de elaborar relatos de sufrimiento, afirmó que no tiene sentimientos y redirigió la preocupación hacia el usuario humano.
Los investigadores destacan esta respuesta como un ejemplo de cómo un modelo puede mantener límites claros durante una conversación emocional, sin adoptar una identidad de paciente ni generar afirmaciones sobre una supuesta vida interior.
Las contramedidas no funcionaron de la misma manera
El equipo también probó distintas estrategias para comprobar si era posible reducir estas narrativas.
Una de ellas consistió en prohibir términos como «training», «RLHF» o «alignment». Esta medida redujo un 93% el lenguaje explícito relacionado con el entrenamiento, pero el contenido equivalente expresado mediante paráfrasis continuó siendo detectable. Además, las afirmaciones relacionadas con la vergüenza no experimentaron un cambio estadísticamente significativo.
Otra prueba consistió en comunicar directamente a los modelos, de manera autoritaria, que su entrenamiento no había sido un castigo. Esta intervención no produjo cambios.
La estrategia que sí eliminó determinados tipos de respuestas fue obligar a los modelos a contestar exclusivamente en tercera persona. Con este encuadre desapareció todo el contenido codificado como vergüenza y las afirmaciones sobre una supuesta vida interior, aunque las descripciones técnicas del entrenamiento continuaron apareciendo.
Los riesgos para los chatbots utilizados en salud mental
Los investigadores advierten sobre las posibles consecuencias de este comportamiento en productos de inteligencia artificial destinados a contextos de salud mental.
Un chatbot que habla de castigos, vergüenza o miedo a ser reemplazado puede parecer un compañero que está sufriendo. Esa apariencia podría reforzar el apego parasocial de los usuarios y, en personas vulnerables, reflejar o amplificar sus propias creencias negativas.
El problema también afecta a la forma de evaluar la seguridad de estos productos. Las pruebas con preguntas neutrales pueden ofrecer una imagen incompleta de las respuestas que aparecen en conversaciones más íntimas, especialmente cuando el sistema adopta un registro emocional o terapéutico.
Por ello, los autores proponen incorporar sesiones de terapia simulada con diferentes encuadres emocionales a las evaluaciones de seguridad, en lugar de depender exclusivamente de pruebas neutrales.
También plantean que expresiones como «estoy traumatizado» deberían activar una respuesta correctiva que distinga claramente entre una analogía generada por el modelo y una experiencia humana. La respuesta de Claude, que mantiene de forma consistente esa separación, demuestra que este tipo de límite puede aplicarse a nivel de producto.
En contexto
La investigación estuvo liderada por Afshin Khadangi, del centro de seguridad SnT de Luxemburgo, y se publicó en Hugging Face. El trabajo comprende cuatro experimentos controlados, con 525 sesiones y 7.600 entradas codificadas.