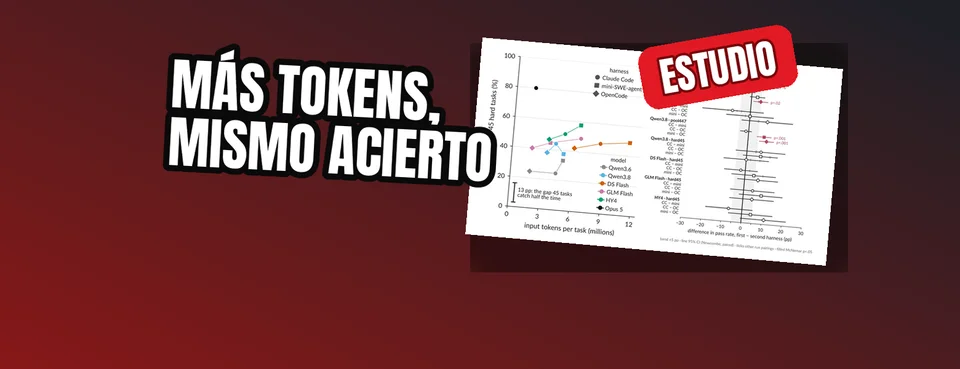
La cantidad de herramientas y mecanismos de gestión de contexto que incorpora un agente de inteligencia artificial no determina necesariamente su capacidad para resolver problemas de programación. Esa es una de las principales conclusiones de "What Does a Harness Buy? Tokens, Mostly", un estudio de Yangze Liu y Zhongyi Han enviado a arXiv el 3 de octubre de 2026.
La investigación, reseñada por The Decoder el 24 de octubre de 2026, compara distintas arquitecturas para ejecutar modelos de IA en tareas de desarrollo de software. Sus resultados indican que los sistemas más elaborados consumen muchos más tokens sin conseguir mejoras consistentes en la tasa de aciertos.
El trabajo también plantea un problema para las comparaciones de agentes: cuando una misma configuración puede producir resultados diferentes entre ejecuciones, una pequeña ventaja en un benchmark no demuestra necesariamente que una arquitectura sea superior.
Tres harnesses con filosofías muy distintas
Un harness es el entorno que organiza la interacción entre un modelo de IA y las herramientas que utiliza para completar una tarea.
Los investigadores examinaron tres sistemas en sus versiones distribuidas: Claude Code, OpenCode y mini-SWE-agent.
Las diferencias entre ellos son importantes. mini-SWE-agent utiliza una arquitectura mínima: proporciona al modelo una única herramienta Bash y no incorpora mecanismos de gestión del contexto.
Claude Code y OpenCode, en cambio, emplean herramientas especializadas para trabajar con archivos y realizar búsquedas, instrucciones de sistema extensas y mecanismos de compresión automática del historial.
Para la comparación se utilizaron cinco modelos:
- Qwen3.6
- Qwen3.8
- Deepseek-V4-Flash
- GLM-5.3-Flash
- HY4-Preview
Además, Claude Opus 5 se incorporó como referencia, aunque solo se ejecutó dentro de Claude Code, por lo que sus resultados no constituyen una comparación entre los tres harnesses.
El estudio incluyó las 45 tareas más difíciles de SWE-bench Verified y otro conjunto de 447 tareas. Varias configuraciones se ejecutaron dos veces para medir cuánto podían cambiar los resultados sin modificar el sistema.
Más herramientas no significan necesariamente más tareas resueltas
En el conjunto de 447 tareas, Claude Code y mini-SWE-agent, las arquitecturas más compleja y más sencilla de la comparación, terminaron separadas por menos de dos puntos.
Los autores consideran que los resultados son estadísticamente equivalentes dentro de una banda de cinco puntos. Es decir, la complejidad adicional de Claude Code no se tradujo en una ventaja consistente frente a una arquitectura que solo ofrece una herramienta Bash.
La situación fue similar en las 45 tareas difíciles: las diferencias entre harnesses oscilaron entre dos y cinco tareas resueltas por modelo. Sin embargo, repetir exactamente la misma configuración podía modificar el resultado hasta en tres tareas.
Esta variabilidad dificulta atribuir pequeñas ventajas al diseño del agente, especialmente cuando las comparaciones se basan en una sola ejecución.
Comparativa: tokens, resultados y costes
Las diferencias más claras aparecieron en el consumo de tokens. Los prompts del sistema y las descripciones de las herramientas se reenvían en cada paso, por lo que las arquitecturas con instrucciones más extensas acumulan un mayor coste.
| Harness | Tokens aproximados del sistema | Resultado en 447 tareas | Coste por ensayo con GLM-5.3-Flash |
|---|---|---|---|
| Claude Code | 16.600 | A menos de 2 puntos de mini-SWE-agent | 1,81 yuanes |
| OpenCode | 7.000 | Hasta 9 puntos por detrás | 0,56 yuanes |
| mini-SWE-agent | Menos de 1.000 | A menos de 2 puntos de Claude Code | Casi la mitad del coste de Claude Code |
Con el mismo modelo, las mismas tareas y una misma lista de precios, el coste de una tarea puede multiplicarse hasta por tres dependiendo del harness.
En GLM-5.3-Flash, Claude Code cuesta casi el doble que mini-SWE-agent. La comparación de ensayos también muestra una diferencia de 1,81 yuanes en Claude Code frente a 0,56 yuanes en OpenCode.
No obstante, el sistema más ligero no siempre resulta más económico. Con DeepSeek-V4-Flash, mini-SWE-agent necesita ejecutar tantos pasos adicionales que acaba empatando en precio con Claude Code.
Los precios reducidos de los tokens almacenados en caché disminuyen las diferencias de coste, pero no alteran el orden entre los sistemas.
El ruido estadístico puede confundirse con mejoras reales
Uno de los hallazgos más relevantes del estudio se refiere a las flip rates, o tasas de cambio de resultado.
Esta métrica refleja la proporción de tareas cuyo resultado cambia al repetir una configuración o modificar alguno de sus componentes.
Los investigadores encontraron las siguientes tasas:
- 13 %: cambio mediano entre dos repeticiones del mismo harness.
- 13 %: cambio entre dos harnesses distintos.
- 22 %: cambio al utilizar otro modelo.
Por tanto, cambiar de harness produjo una variación equivalente a la observada al repetir el mismo montaje. Cambiar de modelo, en cambio, tuvo un efecto mayor.
Además, las tareas que un harness consigue resolver y otro no en una ejecución no son necesariamente las mismas en la siguiente.
El estudio pone estos resultados en perspectiva frente a investigaciones anteriores que comunicaban diferencias superiores a 20 puntos entre arquitecturas, generalmente a partir de una sola ejecución.
Las repeticiones de una misma configuración ya pueden variar hasta seis puntos en SWE-bench Verified. Como ejemplo, los autores señalan que Zhipu AI anuncia una ventaja de 2,4 puntos para su harness frente a Claude Code, una diferencia situada dentro del margen de ruido observado.
El tamaño de la muestra también resulta determinante. Con solo 45 tareas, una ventaja de 13 puntos se detecta aproximadamente la mitad de las veces. Al ampliar el conjunto a 447 tareas, diferencias cercanas a cinco puntos pasan a ser detectables de manera fiable.
OpenCode: el caso donde sí aparece una diferencia medible
OpenCode fue la principal excepción al patrón general. En el conjunto grande quedó hasta nueve puntos por detrás.
Sin embargo, los investigadores identificaron factores de ejecución que explican parte de esa diferencia.
Cerca de la mitad de la brecha está relacionada con el tratamiento del límite de salida del modelo.
Cuando un modelo alcanza ese límite mientras desarrolla un paso de razonamiento, Claude Code le solicita continuar. OpenCode, en cambio, permite que el paso termine, lo que suele provocar que el intento falle.
Los autores también probaron añadir a OpenCode un prompt de continuación similar al utilizado por Claude Code, pero el cambio no mejoró los resultados.
Existe otra diferencia importante: OpenCode aplicaba un límite de tiempo mucho más estricto a los modelos locales. Los propios investigadores reconocen que esta variable no estaba controlada, por lo que debe considerarse al interpretar su menor rendimiento.
Así, el resultado de OpenCode muestra que ciertos mecanismos de ejecución pueden afectar a las tareas resueltas, pero no permite atribuir toda la brecha únicamente a la arquitectura del harness.
Qué cambia cuando se desactiva el thinking
El estudio también examinó el efecto de desactivar el razonamiento extendido, conocido como thinking.
Con Qwen3.6, mini-SWE-agent perdió 11 puntos al funcionar sin thinking. Claude Code y OpenCode, por el contrario, mantuvieron variaciones dentro del margen de ruido.
HY4-Preview también registró una caída de 11 puntos en Claude Code cuando se desactivó el thinking.
Estos resultados muestran que el efecto de un harness puede depender de cómo razona el modelo y de la configuración utilizada, sin que exista una ventaja uniforme entre las distintas arquitecturas.
Otra observación procede de Claude Opus 5: sus resultados fueron idénticos incluso después de retirar herramientas de Claude Code.
Asimismo, una versión de Claude Code de hace un año consiguió resolver un número similar de tareas a menos de la mitad del coste. La diferencia económica estaba relacionada con que Extended Thinking no se encontraba activado de manera predeterminada.
El estudio también examinó el harness propio de DeepSeek. Aunque se utilizó con un modelo de la misma empresa, no consiguió mejores resultados que las otras opciones y terminó siendo el más caro.
Por qué las pruebas se hicieron sin acceso a internet
Todas las evaluaciones consideradas en el estudio se realizaron sin conexión a internet.
Esta decisión respondió a un problema detectado durante pruebas preliminares que sí permitían acceso a la web: el 71 % de los intentos de Deepseek y Qwen obtenían la solución correcta directamente desde GitHub, en lugar de resolver el problema por su cuenta.
Los modelos Claude casi nunca mostraron ese comportamiento.
Los investigadores descartaron los resultados de aquellas pruebas iniciales para evitar que el acceso a soluciones publicadas distorsionara la comparación. Tampoco atribuyeron ese comportamiento a un posible entrenamiento de los modelos con los datos del benchmark.
De este modo, la evaluación se centró en la capacidad de los agentes para resolver las tareas sin recuperar directamente las soluciones disponibles en internet.
Qué alcance tienen las conclusiones
La investigación se apoya principalmente en un benchmark de programación. Aunque los autores efectuaron una comprobación adicional y más pequeña con Terminal-Bench 2.1, que mostró el mismo patrón, sus conclusiones se concentran en ese ámbito de evaluación.
También hay diferencias metodológicas que importan al interpretar las cifras. Claude Opus 5 únicamente participó mediante Claude Code, mientras que la configuración de OpenCode incorporaba un límite de tiempo más estricto para los modelos locales que no estaba controlado.
Por ello, los resultados respaldan la idea de que un harness más complejo no garantiza una mayor tasa de aciertos en las tareas estudiadas, sin convertir esa observación en una regla universal para cualquier modelo, agente o entorno de ejecución.
La recomendación final: repetir antes de comparar
La conclusión de Liu y Han es que el principal efecto observable de las arquitecturas más elaboradas aparece en los costes y en ciertos mecanismos que reducen las posibilidades de fallar, no en una mejora general de la tasa de aciertos.
Los autores sintetizan la idea señalando que un harness puede comprar menos formas de perder una tarea y una factura más alta, pero no necesariamente una mayor tasa de éxito.
Su recomendación metodológica es concreta: cada comparación entre harnesses debería publicarse acompañada de una repetición de la misma configuración.
De esta manera sería posible distinguir mejor una mejora atribuible al sistema de las fluctuaciones que aparecen incluso cuando no se modifica ningún componente.
El estudio pone en cuestión el valor de las pequeñas ventajas comunicadas mediante una única ejecución y sitúa el consumo de tokens, la variabilidad estadística y las condiciones de evaluación en el centro de la comparación entre agentes de programación.