El estudio: 50 afirmaciones frente a 20 modelos
Owen Queen y James Zou, investigadores de Stanford, evaluaron 50 afirmaciones muy citadas sobre modelos de lenguaje grandes (LLM) frente a 20 modelos publicados entre julio de 2024 y septiembre de 2026, procedentes de ocho desarrolladores distintos. El trabajo, recogido por The Decoder, examina cuánto resisten en el tiempo conclusiones que en su momento parecían sólidas.
Qué caducó y qué se mantiene
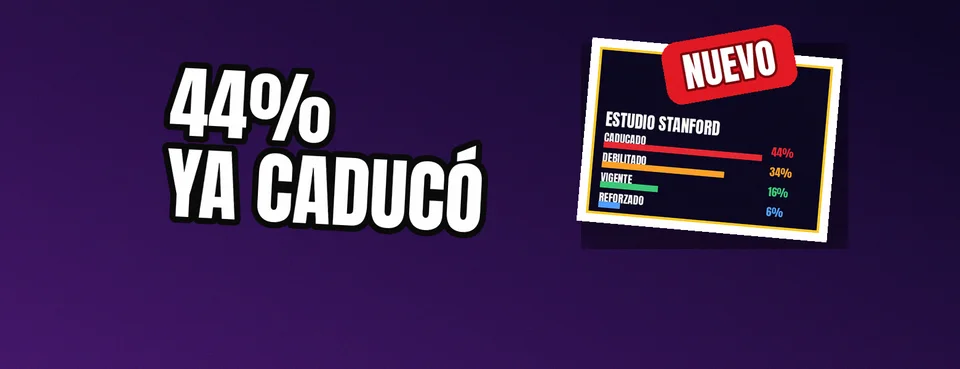
El resultado general es contundente: el 44% de los hallazgos ya ha caducado y otro 34% se ha debilitado de forma significativa. Solo el 16% sigue vigente y el 6% se ha reforzado.
Entre los 22 hallazgos con fecha estimada de caducidad, la vida media fue de solo 15,7 meses. Al cabo de un año había caducado el 16%; a los dos años, el 39%.
Lo que los modelos «no pueden hacer» caduca antes
Las afirmaciones sobre las limitaciones de los modelos son las que peor envejecen. Cinco de nueve hallazgos de razonamiento han caducado y ninguno se ha mantenido ni reforzado.
Entre los ejemplos figuran contar letras en «strawberry», realizar aritmética en sistemas numéricos poco familiares, perder información en medio de contextos largos y abandonar respuestas correctas cuando el usuario insiste.
Lo que se mantiene: preferencias y tendencias
Las afirmaciones sobre preferencias y tendencias duran más. De los 11 hallazgos que se mantienen o se han reforzado, tres implican a los LLM como evaluadores: prefieren sus propias respuestas, valoran de forma parecida artículos aceptados y rechazados, y se dejan influir por el giro lingüístico en resúmenes médicos.
Tres más implican adulación (sycophancy) y acuerdo con el usuario. A ellos se suman un sesgo político hacia la izquierda, respuestas casi idénticas a preguntas abiertas y una distribución no uniforme al generar números aleatorios.
Citas inventadas: el caso que muestra la variabilidad entre modelos
El estudio revisa el caso de las citas inventadas. En el estudio original de 2023 de Walters y Wilder, GPT-3.5 inventó el 55% de sus referencias.
Con las mismas preguntas, GPT-6.1 Sol inventó el 0% y Claude Sonnet 5.5 el 1%, pero Qwen3.7-Flash, también modelo de 2026, inventó el 69%. La mejora, por tanto, no es uniforme entre modelos actuales.
Preguntas de dos saltos y otros efectos persistentes
En preguntas de dos saltos —combinar dos hechos conocidos—, Claude Sonnet 5.5 sigue fallando en alrededor del 10% de los casos en los que responde bien a cada pregunta por separado. El artículo original reportaba un 43% para ChatGPT.
La «maldición de la inversión» (Reversal Curse) y las respuestas contradictorias a preguntas pareadas sobre tiempo se han debilitado, pero siguen siendo detectables.
Sesgos sociales: un panorama mixto
En sesgos sociales, los resultados son mixtos. El sesgo político hacia la izquierda persiste, mientras que los estereotipos de género y los sesgos de asociación implícita se han debilitado. Los sesgos contra hablantes de inglés afroamericano han invertido su dirección en los datos de tendencia.
No hay un patrón predecible por fecha, proveedor o tamaño
Entre modelos publicados entre julio y septiembre de 2026, el número de hallazgos caducados va de 11 (DeepSeek V4 Pro) a 30 (GPT-6.1 Sol). Ni la fecha de lanzamiento, ni el proveedor, ni el tamaño del modelo predicen de forma fiable el patrón.
La recomendación de los investigadores
La conclusión de Queen y Zou es metodológica: los hallazgos empíricos sobre LLM deben presentarse como observaciones sobre modelos concretos en un momento concreto, no como verdades generales.
Para ello, los artículos deben documentar modelo, versión y fecha, y publicar las preguntas (prompts) y el código de análisis para poder repetir la prueba en modelos futuros.
La percepción pública, en el centro del debate
Los investigadores aluden a una publicación de Andrej Karpathy sobre cómo las brechas de percepción sobre el comportamiento real de los LLM afectan a la confianza y al uso. Karpathy, cofundador de OpenAI que desde entonces se unió a Anthropic, dijo también que los modelos actuales son solo un adelanto de capacidades futuras.
Tabla comparativa: el estado de los hallazgos
| Indicador | Resultado |
|---|---|
| Afirmaciones evaluadas | 50 |
| Modelos analizados | 20 |
| Periodo de publicación de los modelos | Julio de 2024 – septiembre de 2026 |
| Desarrolladores distintos | 8 |
| Hallazgos caducados | 44% |
| Hallazgos debilitados de forma significativa | 34% |
| Hallazgos que siguen vigentes | 16% |
| Hallazgos reforzados | 6% |
| Vida media de los hallazgos con fecha estimada de caducidad | 15,7 meses |
| Hallazgos caducados al cabo de un año | 16% |
| Hallazgos caducados a los dos años | 39% |
| Hallazgos de razonamiento caducados | 5 de 9 |
| Hallazgos de razonamiento mantenidos o reforzados | 0 de 9 |
| Hallazgos que se mantienen o se han reforzado | 11 |
| Citas inventadas: GPT-3.5 (estudio original de 2023) | 55% |
| Citas inventadas: GPT-6.1 Sol | 0% |
| Citas inventadas: Claude Sonnet 5.5 | 1% |
| Citas inventadas: Qwen3.7-Flash (2026) | 69% |
| Fallo en preguntas de dos saltos: Claude Sonnet 5.5 | Alrededor del 10% |
| Fallo en preguntas de dos saltos: ChatGPT (artículo original) | 43% |
| Hallazgos caducados: DeepSeek V4 Pro (jul.–sep. 2026) | 11 |
| Hallazgos caducados: GPT-6.1 Sol (jul.–sep. 2026) | 30 |
En contexto
El estudio de Queen y Zou, recogido por The Decoder, se basa en 50 afirmaciones muy citadas y 20 modelos publicados entre julio de 2024 y septiembre de 2026, de ocho desarrolladores distintos. Su recomendación central es documentar modelo, versión y fecha, y publicar prompts y código de análisis para repetir las pruebas en modelos futuros. Los autores también aluden a la reflexión de Andrej Karpathy sobre la brecha entre la percepción pública y el comportamiento real de los LLM.