Los agentes de inteligencia artificial que trabajan con documentación empresarial necesitan algo más que recuperar fragmentos de texto. Cuando una respuesta depende de varias políticas, versiones de documentos o referencias cruzadas, el agente debe reconstruir las relaciones entre las fuentes para comprender qué información sigue siendo válida.
LangChain investigó este problema utilizando OpenWiki, su compilador de wikis de código abierto construido sobre Deep Agents, como una capa de memoria persistente. El proyecto también incorporó un grafo de evidencia para ayudar a los agentes a recorrer las conexiones entre documentos y afirmaciones.
Los resultados muestran una diferencia importante: mientras que la búsqueda tradicional ofrece resultados similares en preguntas sencillas, una wiki compilada puede mejorar considerablemente las respuestas que requieren razonamiento entre múltiples fuentes.
Por qué los agentes necesitan memoria persistente
Las organizaciones almacenan conocimiento en políticas, manuales, wikis, tickets y repositorios de código. Esa información puede estar distribuida entre documentos extensos, contener referencias indirectas o incluir reglas que han cambiado con el tiempo.
El problema resulta especialmente relevante en sectores como la banca y los seguros, donde las políticas se actualizan o reemplazan con frecuencia.
Cuando un agente carece de memoria persistente, necesita reconstruir el contexto documental en cada consulta. Este proceso incrementa el coste y puede producir errores al interpretar relaciones entre fuentes.
La propuesta investigada por LangChain consiste en compilar una representación reutilizable del conocimiento, conservar las referencias a los documentos originales y actualizar las afirmaciones afectadas cuando cambian sus fuentes.
Paso 1. Construir una biblioteca documental con hechos controlados
LangChain creó una biblioteca sintética de seguros diseñada para reproducir dificultades habituales en la documentación empresarial.
El corpus contenía:
- 111 documentos extensos, con diferentes formas de redacción y longitudes.
- 972 hechos controlados, registrados para evaluar las respuestas.
- Versiones antiguas y documentos con información contradictoria.
- Cadenas de referencias indirectas entre documentos.
- Documentos especialmente largos que exigían localizar información específica.
La biblioteca sirvió como base para comparar dos formas de recuperación de información.
Search: un agente que utilizaba búsqueda por palabras clave sobre los documentos originales.
Wiki: el mismo agente, pero con acceso a una wiki compilada mediante OpenWiki, con citas que remitían a las fuentes.
Para mantener la comparación, LangChain conservó el mismo modelo, instrucciones, documentos y preguntas en ambas condiciones.
La evaluación incluyó 80 preguntas sencillas de búsqueda y 50 preguntas conectadas, que necesitaban seguir dependencias entre documentos. Cada pregunta se ejecutó tres veces.
Paso 2. Compilar el conocimiento con OpenWiki
OpenWiki transforma la biblioteca documental en una wiki que el agente puede consultar como memoria persistente.
En el experimento, LangChain compiló los 111 documentos en una wiki cuyo tamaño era aproximadamente una décima parte del corpus original.
| Operación | Resultado |
|---|---|
| Documentos originales | 111 |
| Tamaño de la wiki | Aproximadamente el 10 % del original |
| Coste de compilación inicial | 4,15 USD |
| Documentos añadidos posteriormente | 17 |
| Coste de añadir cada documento | Aproximadamente 0,09 USD |
Cómo mantiene actualizada la información
Uno de los componentes fundamentales de OpenWiki es el claim, una afirmación vinculada a las líneas concretas de las que procede y al hash correspondiente.
Cuando esas líneas cambian, también cambia su hash. OpenWiki puede identificar las afirmaciones afectadas mediante este mecanismo, sin realizar una llamada al modelo para detectar el cambio.
Después, únicamente las afirmaciones identificadas pasan al modelo para determinar si deben confirmarse, revisarse o retractarse.
Este enfoque permite que la memoria se corrija conforme evoluciona la documentación. Además, reduce el consumo de tokens en la detección de cambios y hace más determinista la identificación de información desactualizada.
Paso 3. Añadir un grafo de evidencia en dos etapas
LangChain amplió OpenWiki con un grafo de evidencia, un mapa ligero que convierte las citas de la wiki en conexiones explícitas entre afirmaciones, páginas, párrafos y temas.
Su construcción se divide en dos operaciones.
3.1. Convertir los párrafos en unidades individuales
El primer paso consiste en dividir cada documento en párrafos y asignar un identificador único a cada uno.
Este procedimiento es determinista y permite almacenar cada párrafo como una nueva unidad básica del sistema.
En lugar de relacionar una afirmación con un documento completo, el grafo puede conectarla directamente con el pasaje que proporciona su evidencia.
Así, los párrafos se convierten en unidades atómicas para representar las relaciones entre afirmaciones y fuentes.
3.2. Conectar las unidades mediante relaciones tipadas
La segunda etapa crea aristas que describen las relaciones entre los elementos del grafo.
Entre las conexiones utilizadas se encuentran:
- cites: una afirmación cita un párrafo.
- supersedes: un documento nuevo reemplaza a otro anterior.
- refers_to: una sección hace referencia a otro documento.
Parte de estas relaciones puede extraerse de manera determinista a partir de las referencias existentes en los documentos.
Como las afirmaciones de OpenWiki ya contienen citas textuales, también es posible materializar relaciones como refers_to y supersedes sin recurrir a una nueva llamada al modelo.
En la biblioteca experimental, el grafo se construyó en menos de un segundo y resolvió todas las referencias cruzadas explícitas.
Paso 4. Navegar por el grafo con locate y expand
Para utilizar las conexiones del grafo, LangChain incorporó dos herramientas de navegación: locate y expand.
Su funcionamiento separa la búsqueda de un punto de partida del recorrido por las relaciones asociadas.
locate: encontrar dónde comenzar
La herramienta locate busca coincidencias entre los términos de una pregunta y los elementos disponibles en el sistema.
Puede localizar puntos de partida mediante títulos de documentos, encabezados de secciones, páginas wiki y afirmaciones.
La firma mostrada en la investigación es:
@tool(parse_docstring=True) async def locate(terms: str, within: str | None = None) -> dict
La descripción incluida en la fuente es:
"Find where to start: match the question's words against document titles, section headings, wiki pages, and claim statements."
expand: recorrer las conexiones
Una vez identificado el nodo inicial, expand permite acceder a sus relaciones con otros elementos.
Su firma es:
@tool(parse_docstring=True) async def expand(node: str, edges: list[str] | None = None, hops: int = 1) -> dict
La herramienta permite abrir un nodo y examinar sus aristas tipadas, entre ellas cites, refers_to, supersedes, amends, attaches_to y sus relaciones inversas.
El parámetro hops controla el recorrido de conexiones. Cuando se utiliza un valor superior a 1 con un tipo de arista, la herramienta puede seguir automáticamente ese tipo de relación mientras exista un único camino.
Si aparecen varias alternativas, el recorrido se detiene en la ramificación y el agente decide por cuál continuar.
De esta manera, el sistema combina navegación automática en trayectorias claras con decisiones del agente cuando existen varias conexiones posibles.
LangChain relaciona este patrón con enfoques GraphRAG, incluido GraphRAG de Microsoft, que también utilizan estructuras de grafos para conectar información.
Paso 5. Medir precisión, consistencia, costes y latencia
LangChain evaluó el comportamiento de los agentes mediante tres grupos de métricas.
Precisión de las respuestas
La métrica Accuracy, comprendida entre 0 y 1, mide la correspondencia de las respuestas y las evidencias citadas con los 972 hechos controlados del experimento.
Un evaluador asignó las puntuaciones considerando los hechos requeridos y penalizando las contradicciones.
Consistencia de las citas
La métrica Consistency, también comprendida entre 0 y 1, mide cuánto coinciden las fuentes citadas cuando se repite una pregunta.
Para calcularla, LangChain utilizó la similitud de Jaccard media por pares entre los conjuntos de evidencias de las tres ejecuciones de cada pregunta.
Coste y latencia
La evaluación también registró el gasto del modelo en dólares y el tiempo necesario para responder cada pregunta.
Los costes de recuperación y respuesta presentados en los resultados siguientes excluyen la compilación inicial y las actualizaciones de la wiki.
Resultados: búsqueda tradicional frente a OpenWiki
Preguntas sencillas: resultados prácticamente equivalentes
En las 80 preguntas simples, ambos métodos consiguieron niveles de precisión muy similares.
| Métrica | Search | OpenWiki |
|---|---|---|
| Precisión | 0,84 | 0,83 |
| Consistencia de citas | 0,72 | 0,74 |
| Coste por respuesta correcta | 0,020 USD | 0,021 USD |
La latencia aumentó de 9 segundos con búsqueda a 12 segundos con la wiki.
Estos resultados indican que la búsqueda directa sigue siendo una alternativa competitiva para localizar hechos puntuales. En este escenario, el acceso a una wiki compilada no produjo una mejora relevante de precisión y la búsqueda tradicional fue más rápida.
Preguntas conectadas: la wiki multiplica la precisión
El comportamiento cambió cuando las preguntas exigían relacionar información procedente de varios documentos.
| Métrica | Search | OpenWiki |
|---|---|---|
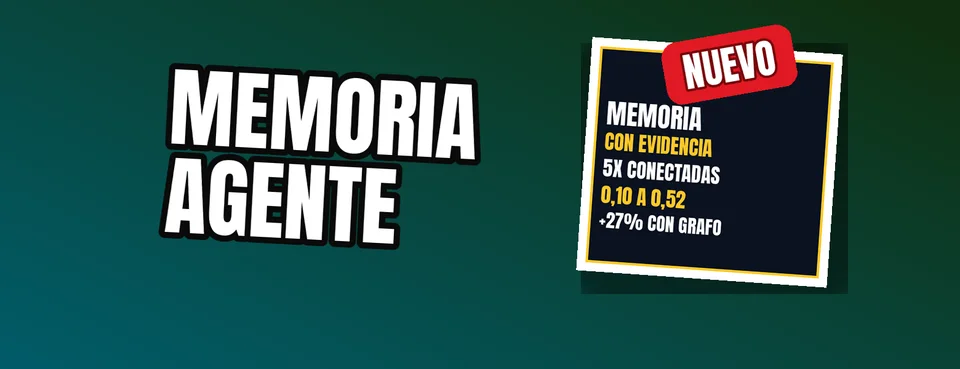
| Precisión | 0,10 | 0,52 |
| Coste por respuesta correcta | Aproximadamente 0,55 USD | Aproximadamente 0,19 USD |
La precisión de OpenWiki pasó a ser aproximadamente cinco veces mayor que la obtenida con búsqueda directa.
También disminuyó considerablemente el coste por respuesta correcta, al reutilizar una representación del conocimiento que ya contenía relaciones documentales.
Sin embargo, apareció una limitación: la consistencia de las citas de la wiki bajó de 0,74 en preguntas sencillas a 0,25 en preguntas conectadas.
Esto significa que, aunque el sistema respondía mejor a las consultas complejas, las fuentes utilizadas podían variar considerablemente entre ejecuciones.
Qué cambió al incorporar el grafo de evidencia
La siguiente parte de la investigación comparó OpenWiki con y sin el grafo.
Los resultados comunicados por LangChain fueron:
| Métrica | Cambio con el grafo respecto a OpenWiki |
|---|---|
| Precisión | +27 % |
| Consistencia de citas | Se duplicó |
| Tiempo mediano de respuesta | −40 % |
| Coste por respuesta correcta | −58 % |
Las mejoras indican que organizar las relaciones entre afirmaciones y pasajes beneficia tanto la calidad de las respuestas como la eficiencia de recuperación.
El grafo ayuda a localizar los documentos relacionados y a seguir sus conexiones sin reconstruir toda la cadena documental desde el principio.
Además, la duplicación de la consistencia de citas aborda una de las principales dificultades observadas en las preguntas conectadas: encontrar respuestas correctas utilizando evidencia más estable entre ejecuciones.
Cuándo compensa construir memoria persistente
La conclusión de LangChain distingue entre consultas puntuales y razonamiento documental recurrente.
Para las búsquedas sencillas, el sistema tradicional alcanzó una precisión equivalente y respondió con mayor rapidez. En este contexto, el coste de compilar y mantener una wiki podría superar el ahorro obtenido durante la recuperación.
La situación cambia cuando un agente necesita resolver repetidamente preguntas que dependen de varias fuentes.
En esos casos, disponer de una representación persistente del conocimiento evita reconstruir las mismas relaciones en cada consulta. Con suficiente reutilización, el ahorro acumulado puede compensar los gastos de creación y mantenimiento.
Por tanto, el principal valor de OpenWiki en este experimento aparece en el razonamiento repetido entre documentos interrelacionados, especialmente cuando las fuentes cambian y es necesario mantener actualizadas sus dependencias.
Próximos pasos: memoria dinámica para agentes
LangChain plantea dos líneas de investigación a partir de estos resultados.
La primera consiste en construir wikis de forma más dinámica, compilando y conservando únicamente el contexto que los agentes necesitan para resolver preguntas entre fuentes.
La segunda explora el uso de afirmaciones y relaciones tipadas como componentes fundamentales de otras formas de memoria para agentes.
Entre ellas se encuentran la memoria semántica, la episódica y la procedimental.
Esta dirección amplía el papel de los grafos de evidencia: además de conectar documentación, sus estructuras podrían servir para organizar distintos tipos de información persistente utilizada por los agentes de IA.
LangChain en contexto
OpenWiki es el compilador de wikis de código abierto de LangChain, construido sobre Deep Agents, que utiliza conocimiento compilado como memoria para agentes. El proyecto cuenta con documentación en el portal oficial de LangChain.