Qué es Together Compiler
Together AI presentó Together Compiler (TKCC), un bucle de compilación continua que utiliza agentes de inteligencia artificial para reescribir el forward pass de los modelos que sirve. El sistema se adapta al tráfico real de producción y busca mejorar el rendimiento de la inferencia sin modificar los pesos ni el comportamiento del modelo.
El lanzamiento se anunció el 4 de noviembre de 2026. Together Compiler es el primer proyecto de la iniciativa Polymorphic Inference, orientada a crear sistemas de inferencia que evolucionan de forma continua.
El sistema ya funciona en varios endpoints serverless de Together AI. La compañía ofrece una beta limitada para despliegues dedicados de clientes y prepara el acceso self-service próximamente.
Cómo funciona el bucle de compilación continua
Together Compiler opera como un bucle que detecta el tráfico real que llega a un endpoint y lo utiliza para optimizar el código que ejecuta el modelo.
El bucle incluye varias fases:
- Captura de tráfico real: el sistema identifica el tráfico de producción de cada endpoint.
- Reescritura del forward pass: los agentes de IA modifican el código que ejecuta el modelo.
- Medición y validación: las nuevas versiones se prueban en el hardware real.
- Despliegue: el mejor código validado se pone en producción.
El proceso se repite de forma continua, por lo que el sistema puede seguir optimizándose a medida que cambia el tráfico o se incorporan nuevas mejoras.
Los resultados: hasta 2,6x más tokens por segundo
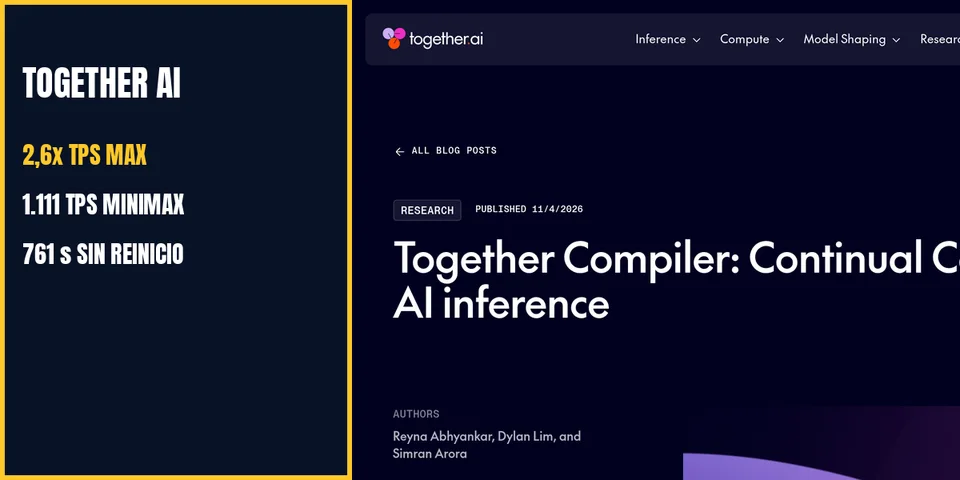
Según Together AI, Together Compiler logra hasta 2,6 veces más tokens por segundo (TPS) en menos de 24 horas por configuración, frente a las mejores configuraciones publicadas de InferenceX (SemiAnalysis, workload AgentX).
Los resultados se obtuvieron con batch size 1 y se expresan en P90 TPS por usuario. Los modelos probados fueron Kimi K3, GLM 5.3, MiniMax M3.1 Flash, DeepSeek v4.1 Flash y Llama 1B. El hardware utilizado incluye NVIDIA B200, B300, GB300 y H100, AMD MI355X y AWS Trainium2.
Resultados comparativos por modelo
| Modelo | Hardware | TPS con TKCC | TPS de referencia (InferenceX) | Mejora |
|---|---|---|---|---|
| MiniMax M3.1 Flash | B200 | 1.111 | 633 | 1,75x |
| DeepSeek v4.1 Flash | GB300 | 1.205 | 943 | 1,28x |
| GLM 5.3 | B200 | 417 | 329 | 1,27x |
| Kimi K3 | GB300 | 450 | 423 | 1,06x |
| GLM 5.3 | MI355X | 480 | 463 | 1,04x |
Todas las cifras de rendimiento son autorreportadas por Together AI. La mejora en GLM 5.3 sobre MI355X es de solo alrededor del 4%, mientras que la mayor mejora se observa en MiniMax M3.1 Flash.
En Llama 1B, Together Compiler logra hasta 1,7 veces más rendimiento frente a megakernels escritos a mano. Además, el sistema aceleró ocho modelos científicos entre 1,5 y 6,4 veces, con salidas bit-exact.
Un motor persistente que evita reinicios de 761 segundos
Una de las claves del sistema es su motor persistente, que evita los reinicios del motor de inferencia cada vez que se prueba una nueva versión del forward pass.
En el caso de MiniMax M3.1 Flash en TensorRT-LLM, cada reinicio del motor tardaba 761 segundos. El motor persistente intercambia el forward por RPC con recaptura de grafos CUDA, lo que permite probar nuevas versiones sin detener el servicio.
El sistema utiliza dos niveles de medición:
- Medición rápida: 12 capas.
- Medición lenta: 60 capas.
Este enfoque permitió probar 8,1 veces más candidatos: 1.354 frente a 168. Además, logró 252 veces más experimentos de agente que la línea base con reinicios.
Los agentes ingenuos superaron a las estrategias de expertos
Otro resultado destacado es que los agentes ingenuos, que trabajan directamente con el código fuente crudo del motor, superaron a las estrategias de expertos.
Las estrategias basadas en una base de conocimiento curada obtuvieron entre un 25% y un 31% menos mejora que los agentes ingenuos. Esto sugiere que, en este contexto, el acceso directo al código fuente permite a los agentes encontrar optimizaciones que no estaban previstas en las guías de expertos.
Together AI en contexto
Together AI es una empresa de infraestructura de inteligencia artificial que opera una plataforma en la nube para entrenar y servir modelos de código abierto y de frontera. La compañía desarrolla sistemas de inferencia y entrenamiento optimizados para distintos tipos de hardware, incluidos GPU de NVIDIA y AMD y aceleradores como AWS Trainium2.
Qué significa para la inferencia de IA
Together Compiler representa un cambio en la forma de optimizar la inferencia: en lugar de depender únicamente de optimizaciones manuales, el sistema utiliza agentes de IA para mejorar de forma continua el código que ejecuta los modelos.
El enfoque combina adaptación al tráfico real, medición en hardware real y un motor persistente que evita interrupciones. Si los resultados se confirman en producción, el sistema podría reducir los costes de inferencia y mejorar la velocidad de respuesta en endpoints de alto tráfico.
Fuentes
- https://www.together.ai/blog/together-compiler-continual-compilation-for-ai-inference
- https://www.businesswire.com/news/home/20261104879153/en/Together-AI-Launches-Together-Compiler-for-Continual-Optimization-of-Open-Source-AI-Models
- https://www.marktechpost.com/2026/11/05/together-ai-together-compiler-continual-compilation-ai-inference/
- https://www.together.ai/together-compiler-paper