Nanbeige4.3-33B: un modelo abierto para agentes de programación y tareas de oficina
Nanbeige LLM Lab, perteneciente a la plataforma de empleo BOSS Zhipin, publicó Nanbeige4.3-33B, un modelo de lenguaje de 33.000 millones de parámetros diseñado para abordar tareas de programación mediante agentes de inteligencia artificial y actividades de oficina asistidas por IA.
El modelo está disponible en Hugging Face bajo licencia Apache 2.0, una característica que permite utilizarlo y adaptarlo bajo los términos de esta licencia.
A diferencia de las arquitecturas de mezcla de expertos (MoE), Nanbeige4.3-33B utiliza una arquitectura densa. Esto significa que sus 33.000 millones de parámetros pertenecen a un único modelo, sin recurrir a la distribución entre expertos especializados propia de los sistemas MoE.
El lanzamiento también incluye Nanbeige4.3-33B-Base, una variante destinada a quienes necesitan realizar sus propios procesos de post-entrenamiento.
Según la información recogida por MarkTechPost el 25 de octubre de 2026, Nanbeige plantea este lanzamiento como parte de una estrategia más amplia para desarrollar modelos capaces de resolver tareas complejas de programación y automatización.
Arquitectura y ventana de contexto de 512K tokens
Una de las características principales de Nanbeige4.3-33B es su ventana de contexto de 524.288 tokens, equivalente a 512K.
El modelo utiliza la arquitectura LlamaForCausalLM, con una configuración de 52 capas y un tamaño de representación interna de 7.168 dimensiones.
Sus especificaciones principales son las siguientes:
| Característica | Nanbeige4.3-33B |
|---|---|
| Parámetros | 33.000 millones |
| Tipo de modelo | Denso, no MoE |
| Arquitectura | LlamaForCausalLM |
| Ventana de contexto | 524.288 tokens (512K) |
| Capas | 52 |
| Dimensión oculta (hidden size) | 7.168 |
| Cabezas de consulta (query heads) | 56 |
| Cabezas de clave-valor (KV heads) | 8 |
| Vocabulario | 166.912 tokens |
| Licencia | Apache 2.0 |
| Formato de pesos | BF16 |
| Tamaño aproximado de los pesos | 66 GB |
Esta configuración constituye la base técnica del modelo tanto para sus funciones de razonamiento como para su utilización en sistemas de programación y automatización.
Razonamiento, herramientas y controles de conversación
Nanbeige4.3-33B incorpora una plantilla de chat que permite configurar distintos aspectos de su comportamiento mediante tres controles.
enable_thinking: activa o desactiva el modo de razonamiento. Esta función se encuentra habilitada de forma predeterminada.
preserve_thinking: permite controlar la conservación del contenido de razonamiento dentro del formato de conversación.
tools: proporciona el mecanismo para incluir herramientas que el modelo puede utilizar durante la ejecución de tareas. La documentación recomienda un formato de llamadas basado en XML.
Estos controles forman parte de la configuración del modelo para escenarios donde se combinan conversaciones, razonamiento y utilización de herramientas externas.
Resultados de Nanbeige4.3-33B frente a Qwen3.8, Muse-Glimmer y Gemma 4
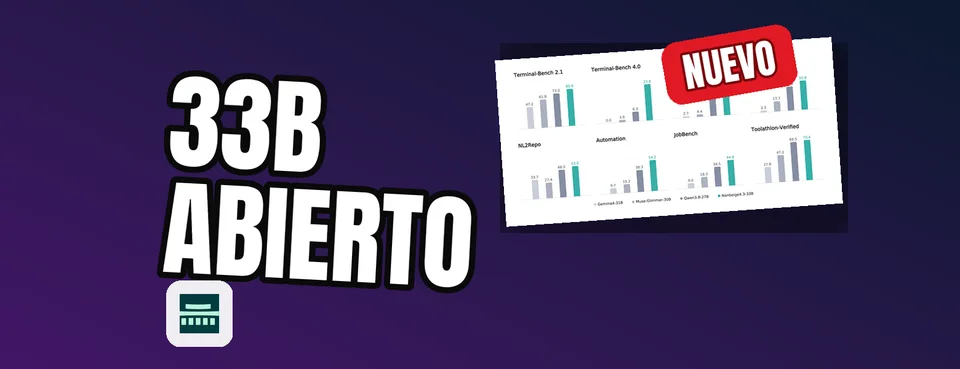
Nanbeige LLM Lab publicó una tabla comparativa que enfrenta su modelo con Qwen3.8-27B, Muse-Glimmer-30B y Gemma4-31B en distintas evaluaciones.
De acuerdo con los resultados autoinformados por el laboratorio, Nanbeige4.3-33B obtiene la mejor puntuación en 17 de las 20 filas de esa comparación.
Entre los resultados destacados aparecen pruebas de trabajo con terminales, ingeniería de software, automatización y tareas profesionales.
Comparativa en programación y automatización
Las siguientes cifras corresponden a los resultados publicados por Nanbeige LLM Lab:
| Evaluación | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 |
| DeepSWE | 65,5 | 42,5 |
| Automation Bench | 54,2 | 38,3 |
| JobBench | 44,8 | 34,5 |
| YC-bench (ganancias simuladas) | 1.025.437 USD | 641.290 USD |
En Terminal-Bench 2.1, Nanbeige comunica una puntuación de 80,9, frente a 73,0 de Qwen3.8-27B.
La diferencia también aparece en DeepSWE, donde los valores informados son 65,5 y 42,5, respectivamente.
Las pruebas Automation Bench y JobBench muestran ventajas de Nanbeige dentro de la misma tabla comparativa.
En YC-bench, la evaluación utiliza ganancias simuladas como indicador. Nanbeige presenta un resultado de 1.025.437 dólares, frente a los 641.290 dólares atribuidos a Qwen3.8-27B.
Estas cifras representan los resultados comunicados por el propio laboratorio en sus evaluaciones.
Resultados en razonamiento y otras evaluaciones
Nanbeige también informa puntuaciones elevadas en pruebas de razonamiento y comprensión de contexto extenso.
| Evaluación | Nanbeige4.3-33B |
|---|---|
| AIME 2026 | 95,2 |
| AA-LCR | 84,0 |
En AIME 2026, el modelo registra una puntuación autoinformada de 95,2, mientras que en AA-LCR alcanza 84,0.
Estos resultados forman parte de las cifras con las que el laboratorio presenta las capacidades generales del modelo, además de su orientación hacia tareas agénticas.
Las evaluaciones donde Nanbeige no lidera
Aunque el laboratorio comunica que su modelo encabeza 17 de las 20 filas comparativas, también aparecen tres evaluaciones en las que otro competidor obtiene una puntuación superior.
| Evaluación | Nanbeige4.3-33B | Competidor | Puntuación del competidor |
|---|---|---|---|
| SWE-Bench Pro | 60,3 | Qwen3.8-27B | 61,7 |
| GDPval | 84,8 | Qwen3.8-27B | 86,4 |
| GPQA Diamond | 89,5 | Gemma4-31B | 91,3 |
En SWE-Bench Pro, Nanbeige aparece con 60,3 puntos, ligeramente por debajo de los 61,7 atribuidos a Qwen3.8-27B.
Una situación similar se presenta en GDPval, donde Qwen alcanza 86,4 frente a los 84,8 de Nanbeige.
En GPQA Diamond, Gemma4-31B figura como el modelo mejor puntuado, con 91,3, mientras Nanbeige registra 89,5.
Sin embargo, algunas cifras atribuidas a los competidores en la tabla de Nanbeige difieren de sus tarjetas oficiales.
Por ejemplo, Google publica una puntuación de 84,3 para Gemma 4 31B en GPQA Diamond, mientras que la comparación elaborada por Nanbeige le asigna 91,3.
La fuente también señala una posible inversión de los valores correspondientes a SWE-Bench Pro.
Por este motivo, las diferencias entre modelos deben interpretarse como parte de la comparación autoinformada por Nanbeige LLM Lab, teniendo presentes las discrepancias identificadas en los resultados de terceros.
Terminal-Bench 4.0: una puntuación mucho menor
Otro dato relevante aparece en Terminal-Bench 4.0.
En esta evaluación, Nanbeige4.3-33B obtiene su puntuación más baja entre los resultados destacados en la fuente.
| Evaluación | Nanbeige4.3-33B | Gemma4-31B |
|---|---|---|
| Terminal-Bench 4.0 | 23,8 | 0,0 |
Aunque Nanbeige supera el valor atribuido a Gemma4-31B en esta prueba, su resultado de 23,8 contrasta con el 80,9 comunicado para Terminal-Bench 2.1.
Ambas puntuaciones corresponden a versiones diferentes de la evaluación y muestran una diferencia considerable entre los resultados presentados para cada una.
Despliegue con Transformers, SGLang y vLLM
Nanbeige LLM Lab acompaña el modelo con recetas de utilización mediante tres herramientas habituales en el ecosistema de modelos abiertos:
Transformers: para trabajar con el modelo mediante esta biblioteca.
SGLang: como alternativa para su ejecución y servicio de inferencia.
vLLM: otra opción contemplada para desplegar el modelo.
Los ejemplos de servidor publicados incluyen configuraciones con paralelismo tensorial de cuatro vías.
El laboratorio también proporciona parámetros recomendados de generación según el tipo de actividad.
| Configuración | Tareas agénticas | Razonamiento y chat |
|---|---|---|
| Temperatura recomendada | 1,0 | 0,6 |
| top_p | 0,95 | — |
| Máximo de tokens nuevos indicado | 65.536 | — |
La recomendación de temperatura para tareas agénticas es 1,0, acompañada de un valor top_p de 0,95 y un límite de 65.536 tokens nuevos.
Para las actividades de razonamiento y conversación, la temperatura recomendada es 0,6.
Los pesos del modelo en formato BF16 ocupan aproximadamente 66 GB, una cifra relevante para dimensionar los recursos necesarios para almacenarlos y desplegarlos.
En el momento de la publicación, ningún proveedor de inferencia integrado en Hugging Face alojaba Nanbeige4.3-33B.
Un modelo profesor para futuras versiones más pequeñas
Nanbeige4.3-33B también ocupa un lugar específico dentro de la estrategia de desarrollo de su laboratorio.
El equipo lo presenta como el modelo profesor de la serie Nanbeige4.3.
El objetivo consiste en utilizar sus capacidades para transferir conocimientos y comportamientos a modelos de menor tamaño mediante procesos de destilación.
El primer modelo previsto dentro de esa estrategia es Nanbeige4.3-3B.
De esta forma, el lanzamiento de la versión de 33.000 millones de parámetros sirve tanto para ofrecer un modelo orientado a tareas complejas como para establecer una base de desarrollo para futuras variantes más compactas.
La publicación independiente de Nanbeige4.3-33B-Base complementa esa estrategia al ofrecer una versión preparada para procesos propios de post-entrenamiento.
Nanbeige en contexto
Nanbeige LLM Lab es un laboratorio de modelos de lenguaje integrado en BOSS Zhipin, una plataforma de empleo.
Con Nanbeige4.3-33B, el laboratorio incorpora a Hugging Face un modelo denso de 33.000 millones de parámetros distribuido bajo licencia Apache 2.0.
La familia contempla una versión Base para post-entrenamiento y una estrategia de destilación que comienza con el modelo Nanbeige4.3-3B, tomando la versión de 33B como referencia principal.