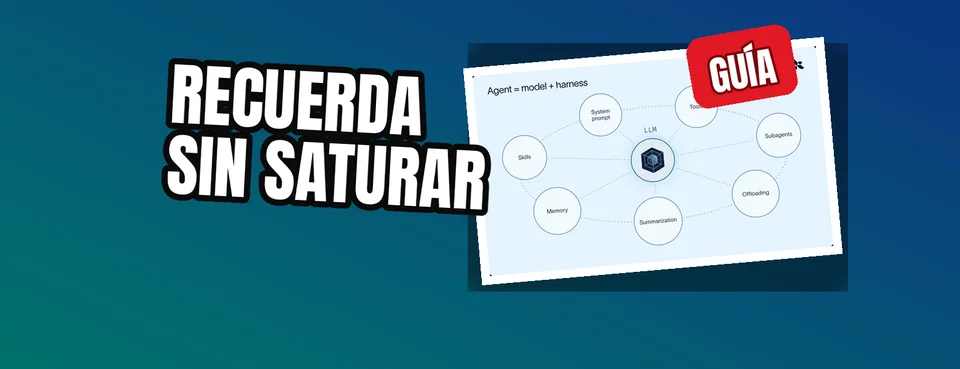
Los agentes de inteligencia artificial necesitan consultar documentos, ejecutar herramientas, conservar instrucciones y recordar decisiones mientras completan tareas. Sin embargo, acumular toda esa información en una misma conversación tiene un costo: cuanto más se llena la ventana de contexto, más puede deteriorarse la precisión del modelo.
Este fenómeno se conoce como context rot y es uno de los problemas que aborda Deep Agents, el harness open source de LangChain.
En su artículo Context Engineering with Deep Agents: How To Remember Without Keeping Everything In Context, publicado el 14 de octubre de 2026 y actualizado el 24 de octubre, LangChain describe cinco técnicas para administrar lo que un agente necesita recordar, consultar o mantener fuera de su contexto inmediato.
Qué es la ingeniería de contexto en Deep Agents
La ingeniería de contexto consiste en administrar la información que recibe un modelo durante la ejecución de una tarea.
En Deep Agents, esta gestión se realiza mediante componentes llamados middleware, que intervienen en distintos momentos del funcionamiento del agente.
El middleware es código que se conecta a puntos específicos del ciclo de ejecución:
- Antes de que el agente comience a trabajar.
- Durante cada llamada al modelo.
- Durante cada llamada a una herramienta.
En esos momentos, puede leer y modificar el contexto antes de que el agente continúe con el siguiente paso.
Así, Deep Agents envuelve el modelo elegido y utiliza diferentes mecanismos para controlar qué información permanece disponible directamente, cuál se almacena en archivos y cuándo conviene recuperar datos anteriores.
1. Offloading: guardar la información extensa fuera del contexto
La primera técnica consiste en trasladar los resultados demasiado grandes al sistema de archivos, en lugar de mantenerlos completos dentro de la ventana de contexto.
Deep Agents utiliza FilesystemMiddleware para administrar este proceso.
Cuando una herramienta devuelve un resultado que supera aproximadamente los 20.000 tokens, el middleware guarda el contenido completo en una ruta específica:
/large_tool_results/{tool_call_id}
En lugar de recibir todo el resultado, el modelo obtiene una vista previa.
El mismo mecanismo se aplica a mensajes humanos especialmente extensos. Por ejemplo, si una persona pega una transcripción que supera los 50.000 tokens, el contenido se almacena en:
/conversation_history/
La información sigue disponible para el agente, que puede recuperarla posteriormente mediante read_file.
| Tipo de información | Umbral aproximado | Almacenamiento |
|---|---|---|
| Resultados extensos de herramientas | 20.000 tokens | /large_tool_results/{tool_call_id} |
| Mensajes humanos extensos | 50.000 tokens | /conversation_history/ |
La ventaja de este método es que el agente conserva acceso a la información original sin tener que mantenerla permanentemente dentro del contexto del modelo.
Además, evita una diferencia importante respecto al simple recorte de contenido: almacenar fuera del contexto permite recuperar los datos; truncarlos supone perder información.
2. Summarization: resumir el historial sin perder acceso a él
La segunda técnica consiste en compactar los mensajes anteriores cuando la conversación comienza a ocupar demasiado espacio.
Para ello, Deep Agents incorpora SummarizationMiddleware.
Su funcionamiento predeterminado utiliza un umbral del 85% de la ventana de contexto.
Cuando el uso cruza ese porcentaje, se realiza una llamada adicional al modelo para resumir la información antigua.
El proceso sigue esta secuencia:
- El agente acumula mensajes durante su ejecución.
- El uso del contexto alcanza el umbral configurado.
- Una llamada independiente genera un resumen de los mensajes antiguos.
- Los mensajes anteriores se eliminan del contexto activo.
- Los mensajes recientes permanecen completos.
La información condensada también queda almacenada en un archivo recuperable:
/conversation_history/{session_id}.md
De esta manera, el agente puede consultar el historial anterior cuando lo necesite.
El mecanismo es recurrente: cuando se produce una nueva compactación, el siguiente resumen incorpora el anterior. Esto permite continuar una ejecución extensa sin conservar todos los mensajes originales dentro de la ventana activa.
La compactación tampoco depende exclusivamente de alcanzar un porcentaje de uso. Deep Agents contempla la posibilidad de resumir al cambiar de tema, lo que permite reorganizar el contexto según la evolución de la tarea.
3. Skills: cargar conocimientos especializados solo cuando hacen falta
Otra manera de reducir el contexto consiste en evitar que el agente reciba todas sus instrucciones especializadas desde el comienzo.
Para eso se utilizan las skills.
Una skill es una carpeta que contiene instrucciones para una tarea específica. También puede incorporar scripts y documentación complementaria.
Deep Agents aplica una técnica llamada progressive disclosure, o divulgación progresiva: el agente comienza con una descripción breve de cada skill y únicamente carga sus instrucciones completas cuando considera que son relevantes para la tarea.
Esto permite incorporar múltiples capacidades sin introducir todos sus documentos en el contexto.
LangChain explica que, con este mecanismo, diez skills pueden consumir aproximadamente el mismo espacio de contexto que diez frases, mientras no sea necesario cargar sus instrucciones completas.
Cómo funciona SkillsMiddleware
El componente responsable es SkillsMiddleware, que interviene en dos momentos:
- Antes de comenzar: examina la carpeta de skills y lee únicamente el encabezado de cada archivo SKILL.md.
- En cada llamada al modelo: incorpora los nombres y las descripciones de las skills al prompt del sistema.
Con esta información, el agente puede identificar las capacidades disponibles y decidir cuándo consultar las instrucciones completas.
El resultado es una separación entre el conocimiento que podría necesitar y el que realmente necesita utilizar en cada momento.
4. Subagents: aislar las tareas que generan demasiado contenido
Algunas tareas producen grandes cantidades de información intermedia.
Investigar una empresa, por ejemplo, puede requerir decenas de búsquedas y generar resultados extensos que no necesitan acompañar al agente principal hasta la respuesta final.
Deep Agents aborda este problema mediante subagentes, que ejecutan trabajos específicos dentro de sus propias ventanas de contexto.
En vez de incorporar todos los resultados al historial principal, el agente recibe únicamente la respuesta final del subagente.
LangChain presenta como ejemplo un subagente llamado:
market-researcher
Este puede realizar una investigación y devolver tres puntos destacados, en lugar de transferir el informe completo con todos los resultados recopilados.
De este modo, el trabajo intermedio permanece aislado y el agente principal recibe información condensada.
Los subagentes también pueden utilizar modelos más económicos y ejecutarse en paralelo.
Esta técnica resulta especialmente relevante cuando una tarea contiene varias investigaciones o procesos independientes que podrían llenar rápidamente el contexto principal.
5. Long-term memory: conservar información entre ejecuciones
La quinta técnica permite mantener información útil sin depender de que permanezca dentro de una conversación.
En Deep Agents, la memoria a largo plazo se almacena en un archivo Markdown.
El componente encargado de administrarla es MemoryMiddleware.
Su funcionamiento comprende tres operaciones:
- Lee el archivo de memoria cuando comienza la ejecución.
- Incorpora su contenido al prompt del sistema en cada llamada al modelo.
- Actualiza el archivo cuando el agente aprende algo que merece conservarse.
Por ejemplo, si el agente aprende que una persona prefiere recibir resúmenes con viñetas en lugar de párrafos, puede guardar esa preferencia en su memoria.
Así, la información puede mantenerse disponible sin tener que reconstruirse mediante todo el historial de conversación.
Una memoria que no depende del proveedor del modelo
Una característica de este mecanismo es que la memoria pertenece al agente y se conserva como un archivo independiente.
Por tanto, es posible cambiar de modelo o proveedor sin perder la información almacenada.
LangChain incluye un ejemplo de configuración mediante create_deep_agent, con el modelo openai:gpt-6 y un archivo de memoria en /memories/AGENTS.md:
create_deep_agent(
    model="openai:gpt-6",
    memory=["/memories/AGENTS.md"]
)
La ruta indica el archivo Markdown utilizado para conservar la memoria del agente.
Cómo instalar Deep Agents
La instalación de Deep Agents se realiza mediante el siguiente comando:
uv add deepagents
Deep Agents utiliza el modelo elegido y sus componentes de middleware para aplicar las técnicas de gestión de contexto descritas anteriormente.
Ejemplo práctico: un agente de análisis competitivo
Para entender cómo se relacionan las cinco técnicas, imaginemos el ejemplo de un agente de análisis competitivo.
Su tarea consiste en investigar cinco competidores cada lunes y redactar un informe utilizando la plantilla del equipo.
Sin una estrategia de ingeniería de contexto, el agente podría llegar al paso final arrastrando cinco exportaciones de datos sin procesar, decenas de resultados de búsqueda y versiones anteriores del informe que ya quedaron obsoletas.
Las cinco técnicas de Deep Agents permiten organizar ese trabajo de otra manera.
| Técnica | Aplicación en el análisis competitivo |
|---|---|
| Offloading | Guarda las exportaciones extensas en archivos para evitar que ocupen continuamente el contexto. |
| Summarization | Condensa el historial anterior y mantiene disponibles los mensajes recientes. |
| Skills | Permite cargar las instrucciones de la tarea especializada cuando resultan relevantes. |
| Subagents | Separa los procesos de investigación y devuelve sus conclusiones al agente principal. |
| Long-term memory | Conserva información útil, como las preferencias sobre el formato de los informes. |
Con esta distribución, los datos extensos, el trabajo intermedio, las instrucciones especializadas y la memoria no necesitan permanecer simultáneamente dentro del contexto activo.
El agente puede concentrarse en la información necesaria para preparar el informe, manteniendo mecanismos para recuperar otros contenidos.
Los cinco métodos de Deep Agents, resumidos
| Método | Componente | Función principal | Dato clave |
|---|---|---|---|
| Offloading | FilesystemMiddleware | Almacenar entradas extensas fuera del contexto | Aproximadamente 20.000 tokens para herramientas y 50.000 para mensajes humanos |
| Summarization | SummarizationMiddleware | Compactar mensajes antiguos | Umbral predeterminado del 85% |
| Skills | SkillsMiddleware | Cargar instrucciones especializadas bajo demanda | Lectura inicial de encabezados SKILL.md |
| Subagents | Subagentes | Aislar tareas extensas en contextos independientes | Solo devuelven el resultado final |
| Long-term memory | MemoryMiddleware | Mantener información persistente en Markdown | Memoria independiente del modelo o proveedor |
Principios para gestionar el contexto de los agentes de IA
Las cinco técnicas descritas por LangChain responden a una misma idea: un agente no necesita mantener toda la información disponible dentro de la ventana de contexto para poder utilizarla.
De ese enfoque se desprenden seis principios:
- Almacenar las entradas extensas en lugar de truncarlas. Mover la información a archivos permite recuperarla posteriormente, mientras que recortarla provoca pérdida de datos.
- Mantener recuperable la información compactada. Los resúmenes permiten reducir el uso de contexto sin convertir el historial anterior en información inaccesible.
- Cargar el conocimiento especializado bajo demanda. Las skills permiten separar las instrucciones disponibles de aquellas que realmente se necesitan en una tarea.
- Aislar el trabajo que genera demasiado contenido. Los subagentes mantienen sus operaciones intermedias fuera del contexto principal y devuelven resultados concretos.
- Conservar una memoria propia. Almacenar información en archivos Markdown permite mantenerla incluso cuando se cambia de modelo o proveedor.
- Permitir que los umbrales sean personalizables. Los valores predeterminados proporcionan puntos de partida, pero la gestión del contexto debe poder ajustarse según las necesidades del agente.
En conjunto, Deep Agents utiliza estos mecanismos para abordar el context rot mediante una distribución más selectiva de la información: conservar lo importante, descargar lo extenso, resumir lo anterior y recuperar los datos cuando vuelvan a ser necesarios.
Fuente: LangChain, Context Engineering with Deep Agents: How To Remember Without Keeping Everything In Context. Publicado el 14 de octubre de 2026 y actualizado el 24 de octubre de 2026.
LangChain también anuncia una clase en vivo para el 3 de noviembre y un curso gratuito disponible en LangChain Academy.